NVIDIA DGX Station - KI-Workstation für lokale Enterprise AI
Entwickeln, optimieren und betreiben Sie anspruchsvolle KI-Modelle direkt in Ihrem Unternehmen. Die NVIDIA DGX Station verbindet leistungsstarke KI-Hardware mit einem vorkonfigurierten NVIDIA Software-Stack und schafft damit eine durchgängige Plattform für Generative AI, Large Language Models, Data Science und Agentic AI.
Auf Basis des NVIDIA GB300 Grace Blackwell Ultra Desktop Superchips bietet die DGX Station 748 GB kohärenten Speicher und bis zu 20 PetaFLOPS KI-Rechenleistung. Damit können Entwickler, Forschungsteams und Data Scientists große KI-Modelle lokal entwickeln, per Fine-Tuning anpassen und für die produktive Inferenz bereitstellen.
Als spezialisierter NVIDIA Partner unterstützt primeline Sie bei der Auswahl des passenden OEM-Systems, der technischen Konfiguration und der Integration in Ihre bestehende KI-Infrastruktur.
Produktdetails Beratung zur NVIDIA DGX Station anfragen
Kategorien
Sortieren nach:

ASUS ExpertCenter Pro ET900N G3 4.0 TB EDU-Edition

ASUS ExpertCenter Pro ET900N G3 8.0 TB EDU-Edition
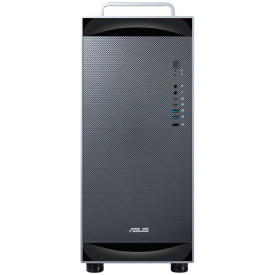
ASUS ExpertCenter Pro ET900N G3 4.0 TB
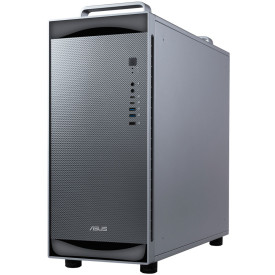
ASUS ExpertCenter Pro ET900N G3 8.0 TB

MSI XpertStation WS300T60L
- MSI XpertStation WS300T60L
- Proprietäres Netzteil
- Grace-72 Core Neoverse V2
- 72 Core Neoverse V2
- 496 GB LPDDR5X + 252 GB HMB3e
- 2x QSFP112, 1x RJ-45 10G
- 1x PCIe 5.0 x16, 2x PCIe 5.0 x16 (x8)
- bis zu 4x M.2 PCIe 5.0 SSD
- NVIDIA DGX™ Station
- 36 Monate Herstellergarantie
- auf bis zu 5 Jahre erweiterbar

MSI XpertStation WS300T60L EDU-Edition
- MSI XpertStation WS300T60L
- Proprietäres Netzteil
- Grace-72 Core Neoverse V2
- 72 Core Neoverse V2
- 496 GB LPDDR5X + 252 GB HMB3e
- 2x QSFP112, 1x RJ-45 10G
- 1x PCIe 5.0 x16, 2x PCIe 5.0 x16 (x8)
- 4x M.2 PCIe 5.0 SSD
- NVIDIA DGX™ Station
- Dekoder: 7x NVDEC | 7x nvJPEG
- 1600 Watt
Preisanfrage
Jetzt vorbestellen
Bewältigen Sie Data Center Workloads - Direkt von Ihrem Schreibtisch aus
Angetrieben vom NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip bietet unsere Lösung leistungsstarke KI-Performance direkt am Arbeitsplatz – für das Training, Fine-Tuning und die Inferenz großer KI-Modelle.
Lokal, leistungsstark und DSGVO-konform – ohne Abhängigkeit von der Cloud.
NVIDIA DGX Station als AI Supercomputer am Arbeitsplatz
Moderne KI-Entwicklung findet längst nicht mehr ausschließlich in großen Rechenzentren statt. Unternehmen benötigen leistungsfähige Systeme, auf denen sie Modelle direkt am Arbeitsplatz entwickeln, testen, optimieren und ausführen können. Genau dafür wurde die NVIDIA DGX Station als leistungsstarker Deskside AI Supercomputer konzipiert.
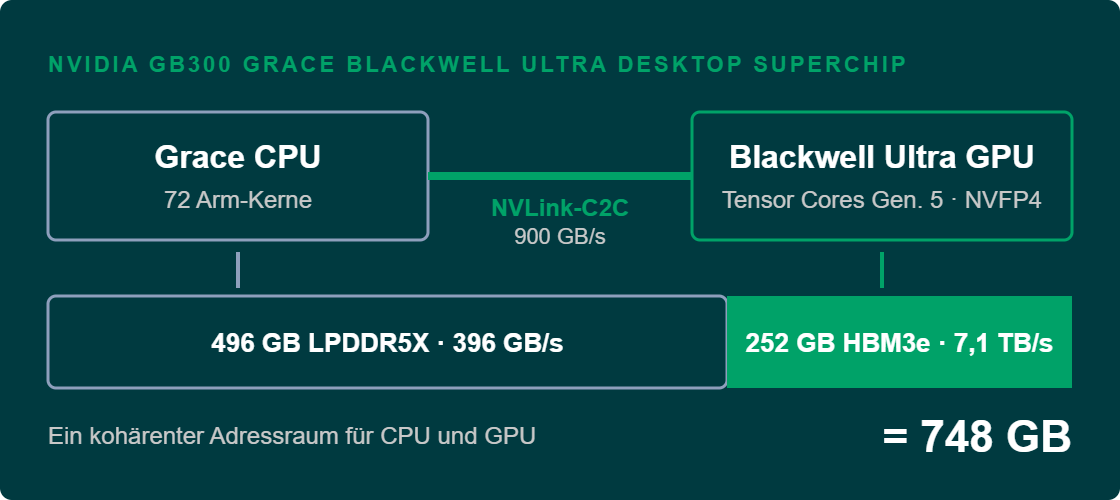
Die Plattform kombiniert eine NVIDIA Grace CPU mit einer NVIDIA Blackwell Ultra GPU. Beide Recheneinheiten sind über NVIDIA NVLink-C2C miteinander verbunden und greifen auf einen großen kohärenten Speicherpool zu. Auf diese Weise werden Engpässe klassischer CPU-GPU-Architekturen reduziert und umfangreiche KI-Workloads können innerhalb einer abgestimmten Systemumgebung verarbeitet werden
Die NVIDIA DGX Station eignet sich unter anderem für:

Was ist die NVIDIA DGX Station?
Die NVIDIA DGX Station ist eine spezialisierte AI Workstation für Entwickler, Data Scientists, Forschungsteams und Unternehmen, die anspruchsvolle KI-Workloads lokal ausführen möchten. Im Unterschied zu einer herkömmlichen GPU Workstation wurde die Plattform von Grund auf für KI-Entwicklung, Data Science, Fine-Tuning und Inferenz ausgelegt.
Ihr technologisches Fundament bildet der NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip. Er kombiniert eine Grace CPU mit 72 Arm-Neoverse-V2-Kernen und eine Blackwell Ultra GPU mit 252 GB HBM3e-Speicher. Ergänzt um 496 GB LPDDR5X-Systemspeicher stehen insgesamt 748 GB kohärenter Speicher zur Verfügung. Die Verbindung über NVLink-C2C erreicht laut NVIDIA eine Bandbreite von 900 GB/s.
Damit schließt die DGX Station die Lücke zwischen klassischer High-End Workstation und hochleistungsorientierter KI-Infrastruktur.
Warum die NVIDIA DGX Station?
Frontier-KI war bisher der Cloud überlassen. Die DGX Station holt sie ins Haus: eigene Modelle, eigene Daten, eigene Kontrolle — mit Enterprise-Software ab Werk und Kosten, die planbar bleiben. Als NVIDIA Elite Partner und ASUS Partner profitieren Sie dabei von direktem Zugriff auf Herstellertechnik, priorisiertem Support und Beratung aus erster Hand — vom konfigurierten System bis zum Service im Betrieb.
Betriebsbereit ab dem ersten Einschalten
NVIDIA validierte Werksausstattung inklusive: DGX OS 7 als Fundament, CUDA-X, NeMo, TensorRT-LLM, NIM und Mission Control direkt einsatzbereit. Der Weg vom Karton zum ersten laufenden Modell dauert Minuten — nicht Tage, und ohne einen einzigen Installationslauf, ohne Treibersuche, ohne Warteschleife beim Support.
Ihre Daten gehören Ihnen - auch technisch
Training, Gewichte, Logs: alles unter eigener Verwaltung, ohne grenzüberschreitende Datenübermittlung. Die Folgelasten aus DSGVO, EU AI Act und Schrems-II — Auftragsverarbeitungsverträge, Transfer Assessments, Auskunftswege — entstehen schlicht nicht.
Der Preis steht fest - vor dem ersten Token
Sie zahlen einmal für die Hardware und danach nur noch den Strom, der messbar durch Ihr Kabel fließt. Sekunden-Tarife, Mindestabnahmemengen und Gebühren für datenexporte fallen ersatzlos weg. Gegenüber der laufenden Cloud-Miete hat sich die Anschaffung in der Regel nach einem bis anderthalb Jahren amortisiert.
Eine Station, sieben Arbeitsplätze
Die NVIDIA Multi-Instance GPU (MIG) Technologie schneidet die Grafikeinheit in bis zu sieben voneinander abgeschottete Rechenbereiche — jeder mit reservierten Ressourcen und ohne Wettbewerb um Speicher oder Rechenzeit. Die Doktorandin trainiert, der Kurs übt, die Pipelines laufen — gleichzeitig und ohne dass sich jemand in die Quere kommt.
Gebaut für Modelle, die nachdenken statt nur antworten
Reasoning-Modelle und KI-Agenten denken in langen Ketten — genau dafür ist Blackwell Ultra geformt. Die Transformer Engine der zweiten Generation beherrscht NVFP4 nativ und beschleunigt Attention-Pfade auf das Doppelte: mehr Denk-Schritte pro Sekunde, ohne mehr Rechenzeit pro Token.
Werksnah an zwei Fronten
Als NVIDIA Elite Partner und ASUS Partner sitzen wir an den direkten Leitungswegen beider Hersteller — bei Technik-Updates, Verfügbarkeit und Eskalationen. Im eigenen Test Center in Glinde verifizieren wir jede Konfiguration, bevor sie ausgeliefert wird. Das Unternehmen dahinter stellt sich seit 1985 derselben Frage: Wie läuft Rechenleistung zuverlässig im Betrieb?
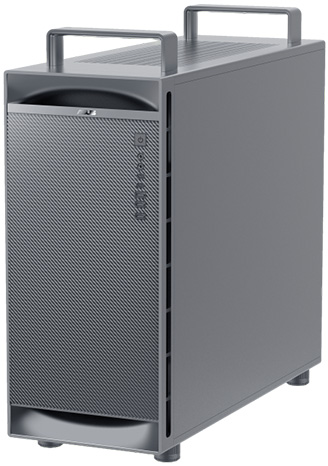
ASUS ExpertCenter Pro ET900N G3

MSI XpertStation WS300T60L
KI-Training lokal
Bereiten Sie Trainingsdaten auf, evaluieren Sie Modelle und führen Sie LLM Training direkt in Ihrer eigenen IT-Umgebung durch, ganz ohne Abhängigkeit von externen Cloud-Diensten. Der große kohärente Speicher unterstützt Machine-Learning- und Deep-Learning-Workloads.
Fine-Tuning von KI-Modellen
Passen Sie Foundation Models mit LoRA oder QLoRA an Ihre Daten, Prozesse und Fachanforderungen an. Die DGX Station dient dabei als leistungsfähige LLM Workstation für Modelle wie Llama, DeepSeek, Mistral, Qwen, Gemma oder NVIDIA Nemotron.
KI-Inferenz lokal
Betreiben Sie RAG-Systeme, KI-Assistenten, multimodale Anwendungen und Agentic-AI-Workflows direkt im Unternehmen. Das reduziert externe Abhängigkeiten und ermöglicht kurze Datenwege sowie mehr Kontrolle über Modelle und Informationen.
Blackwell Ultra: was das Update wirklich bringt
Gegenüber dem regulären Blackwell-Chip sitzt jede Schraube dort, wo Inferenz Zeit kostet: Attention arbeitet mit doppeltem Durchsatz, dichte FP4-Rechenlast läuft 1,5-mal schneller, und der Speicher ist um die Hälfte gewachsen. Reasoning-Ketten, multimodale Modelle und Agenten-Systeme sind exakt die Workloads, für die dieser Chip geschnitten wurde.
Kohärenz statt Kompromiss: NVLink-C2C
Mit 900 GB/s — ungefähr dem Siebenfachen von PCIe Gen 5 — verschmelzen 252 GB HBM3e und 496 GB LPDDR5X zu einem homogenen 748-GB-Adressraum über Grace und Blackwell Ultra. Eine Milliarde? Eine Billion Parameter? Kein Split über Geräte, kein Overhead durch Model-Parallelität. Für den Betrieb heißt das: ein Modell, ein Prozess, ein Ergebnis.
ConnectX-8 SuperNIC: 800 Gb/s, On-Die-PCIe-Gen-6-Switch
NVIDIA legt den PCIe-Gen-6-Switch direkt auf den NIC-Die — ein Branchenvorstoß, den bisher kein anderer Netzwerkcontroller bietet. Die Konsequenz für die Praxis: Zwei DGX Stationen verschmelzen über 800 Gb/s direkt zu einem System mit rund 1,5 TB kohärentem Speicher und 40 PFLOPS FP4. Switch, Kabelsalat und zusätzliche Lizenzkosten bleiben außen vor.
Billionen-Modelle, einzelne Station
Rund 500 GB Gewichtsdaten für ein Modell mit einer Billion Parametern — Platz genug im 748-GB-Speicher der DGX Station. Möglich macht es NVFP4: Ein 4-Bit-Float-Format, dessen Qualität gegenüber FP8 um unter 1 % abweicht und das den Speicherbedarf gegenüber FP16 auf etwa ein Drittel drückt (Faktor ~3,5). Kein Experiment, sondern etabliert: TensorRT-LLM, vLLM und SGLang nutzen NVFP4 nativ.
NVIDIA Grace CPU - 72 Cores ARM Neoverse V2
Grace bringt 72 Neoverse-V2-Kerne in ARM-Bauweise mit und hängt sich über NVLink-C2C direkt an die Blackwell-Ultra-GPU: kein Hin-und-Her-Kopieren über PCIe, ein einziger kohärenter Adressbereich. 396 GB/s LPDDR5X-Bandbreite stehen bereit — rund dreimal so viel wie ein typischer DDR5-Server bewegt, bei sparsamerem Energiebedarf. Während die GPU rechnet, übernehmen die Kerne Vorverarbeitung, Tokenisierung und die gesamte Datenpipeline.
NVIDIA DGX Station - Technische Spezifikationen im Überblick
| Modell | NVIDIA DGX Station |
|---|---|
| Anwendungsgebiete | Modellentwicklung, Inferenz, Forschung |
| NVIDIA GPU | NVIDIA Blackwell Ultra |
| NVIDIA CPU | Grace-72 Core Neoverse V2 |
| GPU-Speicher | 252 GB HBM3e | 7.1 TB/s |
| CPU-Speicher | 496 GB LPDDR5X | 396 GB/s |
| NVLink C2C | 900 GB/s |
| Netzwerk | max. Bandbreite | NVIDIA ConnectX®-8 SuperNIC | Bis zu 800 GB/s |
| Betriebssystem | NVIDIA DGX OS |
| Multi-Instance-GPU (MIG) | 7 |
| max. Leistungsaufnahme | 1600 Watt |
| Dekoder | 7x NVDEC | 7x nvJPEG |
| Storage | 4x M.2 Steckplätze (PCIe 5.0) |
| Ethernet | 2x QSFP112 1x RJ-45 10G 1x RJ-45 BMC |
| PCIe-Slots | 1x PCIe 5.0 x16 2x PCIe 5.0 x16 (x8) |
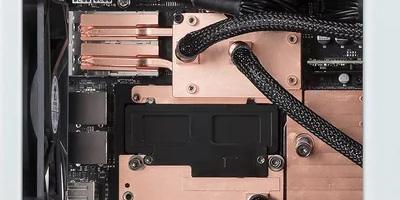
AIO Kühlkreislauf
Geschlossene Flüssigkeitskühlung hält 1.600 W Systemleistung leise und bürotauglich.
NVIDIA GB300 Superchip
Grace-CPU und Blackwell-Ultra-GPU sind über NVLink-C2C mit 900 GB/s kohärent verbunden.
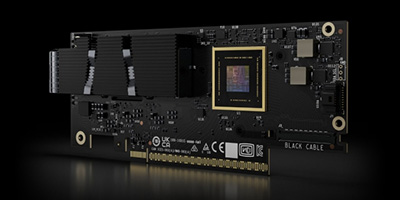
NVIDIA ConnectX-8 SuperNIC
Zwei QSFP-Ports mit je 400 GbE verbinden zwei Stationen direkt, ohne externen Switch.
Performance Test aus unserem Labor
Wir wollten es genau wissen: Unser Technikteam hat das ET900N G3 in unserem Testlabor auf Herz und Nieren geprüft – von der Rechenleistung über die Speichergeschwindigkeit bis zu Lautstärke und Stromverbrauch im Leerlauf und unter Volllast.
Wissenschaft braucht keinen Datenzentrum-Umweg mehr
Was bisher nur in Cloud-Regionen oder großen Rechenzentren ging, steht ab sofort auf dem eigenen Schreibtisch: Hochleistungs-Inferenz, Reasoning-Agenten und multimodale Erzeugung, betrieben auf einer einzigen Station. Eine Datenreise nach außerhalb entfällt — relevant für Hochschulen, Kliniken und F&E-Abteilungen mit sensiblen Datenbeständen.
| Einsatzszenario | Passende Modelle / Frameworks |
|---|---|
| Große Sprachmodelle trainieren und betreiben | Llama 4 Maverick, Qwen3-235B, DeepSeek-V3.2, Mistral Large 3, Nemotron |
| Adaption eigener Fachmodelle per LoRA / QLoRA | Fachmodelle, trainiert auf dem eigenen Datenbestand |
| Bild, Video und Vision-Language | Cosmos, FLUX.2, Vision-Language-Modelle |
| Autonome Agenten mit Denk-Ketten | Chain-of-Thought, Best-of-N, Tool-Use |
| Biologie, Medizin und Klinik-Forschung | BioNeMo, MONAI, FLARE (föderiertes Lernen) |
| Robotik, Simulation und virtuelle Abbilder | Isaac, Omniverse, Holoscan, Digital Twins |
| Rechenintensive Wissenschaft | RAPIDS, CUDA-X, Simulation |
Was auf einer einzelnen Station Platz findet
748 GB zusammenhängender Speicher, dazu Inferenz in nativer NVFP4-Präzision: Was früher Serverschränke füllte, passt jetzt an den Forschungsplatz — und die Messlatte für Einzel-Workstations liegt ein gutes Stück höher. Wenn es noch mehr sein darf, wachsen zwei Stationen über ConnectX-8 zu einem gemeinsamen System zusammen.
| Betriebsart | Realistischer Modellrahmen |
|---|---|
| Inferenz mit NVFP4 (4-Bit-Gewichte) | Modelle bis ~1 Billion Parameter |
| Inferenz mit FP8 | ~400 Mrd. dichte / 671 Mrd. MoE-Parameter |
| Feinjustierung per LoRA / QLoRA | 200 bis 400 Mrd. Parameter (MoE / NVFP4-quantisiert) |
| Vollständige Neu-Trainierung (BF16) | ~70 Mrd. im HBM; 200 Mrd. über LPDDR-Speicher |
| Gemeinsame Nutzung mehrerer Nutzer (MIG) | Maximal 7 getrennte GPU-Bereiche |
| Token-Tempo der Inferenz | 250.000 Tokens pro Sekunde (NVIDIA CES 2026) |
| Zwei gekoppelte Stationen | ~1,5 TB gemeinsamer Speicher / 40 PFLOPS FP4 |
Vollständig vorkonfigurierter NVIDIA AI Enterprise Software Stack
Bei herkömmlichen Systemen vergeht oft ein Monat mit Einrichtung, bevor das erste Modell überhaupt läuft. Die DGX Station kommt mit fertig montierter, NVIDIA-validierter Software aus dem Werk — das erste Inferenz-Ergebnis erscheint, bevor die Rack-Schrauben alle angezogen sind.
NVIDIA AI Enterprise & Mission Control
NVIDIA AI Enterprise bietet Enterprise-Support und über 100 validierte Frameworks. Mission Control orchestriert Jobs, MIG-Partitionen und Cluster-Verbünde aus zwei gekoppelten DGX Stations.
CUDA-X, NeMo, TensorRT-LLM
CUDA 13+, cuDNN, cuBLAS, NCCL, RAPIDS, PyTorch, TensorFlow, JAX. NeMo-Framework für Retriever und Megatron-LM-Training. TensorRT-LLM ab 0.15 mit nativer NVFP4-Unterstützung. Triton Inference Server für skalierbare Inferenz.
NIM Microservices & Blueprints
Vorkonfigurierte NIM-Microservices für Llama Nemotron, Cosmos, Nemotron 3 sowie Modelle von Drittanbietern (Llama, Mistral, Qwen, DeepSeek). Blueprints für Wissensgraphen, Retrieval-Pipelines und sichere autonome Agenten.
Open-Source & Third-Party
Hugging Face Hub, vLLM, SGLang, Ollama, llama.cpp (mit NVIDIA-Optimierungen), LLaMA Factory sind offiziell unterstützt. DGX Spark Playbooks (GitHub) bieten 40+ fertige Rezepte – die Station-Versionen folgen fortlaufend.
Zielgruppen & Anwendungsfelder
Seit über 15 Jahren entwickeln wir maßgeschneiderte Server-, Storage- und HPC-Lösungen – von der individuellen Beratung bis zum erstklassigen Service. Mit über 15 Jahren Erfahrung und über 5.000 Kunden aus den Bereichen der öffentlichen Einrichtungen, Industrie, Produktion und Forschung ist unser Anspruch immer der gleiche: Kompetente Beratung und die Bereitstellung maßgeschneiderter Hardware für jeden Anwendungsfall. Vom kleinen Produktivumfeld bis hin zu großen Cluster-Lösungen werden wir sämtlichen Anforderungen gerecht.
Industrie & Produktion
Vom digitalen Zwilling bis zur Predictive Maintenance: In der Fertigung entscheiden Sekunden über Stillstandskosten. Die DGX Station bringt KI-Modelle direkt dorthin, wo sie gebraucht werden, in die Entwicklung, in die Qualitätsprüfung, an die Linie. Trainieren Sie Inspektionsmodelle und Simulations-KIs lokal, ohne Datenhoheit abzugeben und ohne Cloud-Abhängigkeit.
Forschung & Lehre
Ob Klimamodell, Molekülsimulation oder medizinische Bildanalyse: Forschung braucht Rechenkraft und gleichzeitig Spielraum für eigene Experimente. Die DGX Station stellt Hochleistungs-GPU-Computing bereit, das sich ohne aufwendige Cluster-Administration in bestehende Institute integrieren lässt. Studierende und Forschende arbeiten an realen Modellen, statt auf geteilte Ressourcen zu warten. Als NVIDIA Elite Partner ermöglichen wir berechtigten Einrichtungen den exklusiven NVIDIA EDU-Rabatt. Kontaktieren Sie uns für weitere Informationen.
Öffentliche Einrichtungen
Sensible Daten, compliance-sichere Umgebungen und dennoch modernste KI-Methodik: Für öffentliche Einrichtungen ist die DGX Station die Lösung, die beides zusammenbringt. Modelle werden trainiert und inference-fähig betrieben, wo sie rechtlich hingehören. On-premise, mandantentrennt und mit voller Kontrolle über die eigene Infrastrukturentwicklung.
IT-Dienstleister und Netzbetreiber
Kunden erwarten Verfügbarkeit, Performance und schnelle Reaktion, rund um die Uhr. Mit der DGX Station erweitern Sie Ihr Portfolio um KI-gestützte Analyse, Kapazitätsplanung und Automatisierung, ohne Ihre eigene Infrastruktur zu verlassen. Ein System, das Ihre Services leistungsfähiger macht und gleichzeitig Ihre Unabhängigkeit von Hyperscaler-Plattformen wahrt.
Health Care
Vom klinischen Entscheidungsmodell bis zur personalisierten Diagnostik: Im Gesundheitswesen gilt besondere Sorgfalt im Umgang mit Patientendaten. Die DGX Station ermöglicht es, KI-Anwendungen zu entwickeln, zu validieren und im Betrieb zu nehmen. Lokal, DSGVO-konform und ohne Datenflüsse nach außen. Was dem Schutz dient, wird zum Fundament besserer Versorgung.
So unterstützt Sie primeline
Die Auswahl einer professionellen KI-Workstation beginnt nicht bei einzelnen technischen Daten. Entscheidend ist, ob Modellgrößen, Software, Speicher, Netzwerk, Stromversorgung und Betriebsmodell zu Ihrem konkreten Anwendungsfall passen.
primeline unterstützt Sie von der ersten Anforderungsanalyse bis zum produktiven Einsatz Ihrer KI-Hardware.
Ihre Vorteile
Individuelle NVIDIA DGX Station Beratung
Wir analysieren Ihre Modelle, Frameworks, Datenmengen, Nutzerzahlen und Inferenzanforderungen. Daraus leiten wir eine passende System- und Betriebsempfehlung ab.
Auswahl des passenden OEM-Systems
Gemeinsam prüfen wir, ob das ASUS ExpertCenter Pro ET900N G3, die MSI XpertStation WS300 oder eine alternative NVIDIA Plattform zu Ihrem Workload passt.
Vorkonfiguration der KI-Umgebung
Auf Wunsch bereiten wir Treiber, Bibliotheken, Container, Frameworks und Entwicklungswerkzeuge für Ihre Projekte vor.
Integration in Ihre IT-Infrastruktur
Wir unterstützen bei Netzwerk, Storage, Identitätsmanagement, Zugriffskonzepten, Monitoring und der Anbindung an bestehende Entwicklungsprozesse.
Support im laufenden Betrieb
Sie erhalten einen zentralen Ansprechpartner für Hardware, Systemintegration und technische Eskalationen.
NVIDIA DGX Station Preis & individuelles Angebot
Der Preis Ihrer NVIDIA DGX Station setzt sich aus gewählten OEM-System, der Speicherausstattung, zusätzlichen GPUs, Softwarelizenzen sowie den gewünschten Integrations- und Supportleistungen zusammen.
Für ein belastbares Angebot berücksichtigen wir unter anderem:
Sie erhalten dadurch keine Standardkonfiguration, sondern ein Angebot, das auf Ihren konkreten Workload abgestimmt ist.
Jetzt Kontakt aufnehmen und von unseren NVIDIA DGX Station Experten beraten lassen
NVIDIA DGX Station FAQ
Antworten auf häufige Fragen rund um Beschaffung, Dimensionierung, Betrieb, Sicherheit und Compliance der NVIDIA DGX Station für lokale Inferenz, Fine-Tuning und Prototyping von Grossmodellen (LLMs), Agenten und generativer KI im Unternehmen.
Tippen, um Fragen live zu filtern.
Was ist die NVIDIA DGX Station und wofür wird sie im Unternehmen eingesetzt?
Die NVIDIA DGX Station ist ein Desktop-KI-Supercomputer auf Basis des Grace Blackwell Superchip (GB300) – eine vollständige KI-Plattform in einem bürofreundlichen Gehäuse, bis zu 20 PetaFLOPS KI-Leistung bietet und trillionenschwere Modelle lokal ausführen kann. Unternehmen nutzen sie für Inference und Fine-Tuning großer Sprachmodelle, Agentic AI, RAG sowie Prototyping – ohne Cloud-Abhängigkeit und bei voller Datensouveränität.
Welche Rechenleistung und welchen Speicher bietet die DGX Station?
- KI-Leistung: bis zu 20 PetaFLOPS (FP4) – beschleunigt durch den NVIDIA B300 Blackwell GPU, gekoppelt mit der Grace-CPU über C2C-Schnittstelle.
- Speicher: bis zu 748 GB kohärentes Systemmemory – ca. 252 GB HBM3e auf GPU-Seite plus 496 GB LPDDR5X auf CPU-Seite.
- Bandbreite: GPU-Speicher mit hoher Transferrate für große Modelle; Modellgrößen bis ~1 Billionen Parameter lokal ausführbar.
Inference, Fine-Tuning oder Prototyping – wofür lohnt sich die DGX Station?
Die DGX Station ist ideal für lokale Inferenz großer Modelle und Fine-Tuning im Enterprise-Maßstab: der große kohärente Memory-Bereich erlaubt es, ganze Modelle ohne aufwendiges Offloading zu laden. Für Massen-Serving mit tausenden concurrenten Instanzen bleiben Rechenzentrums-Cluster (DGX/HGX) wirtschaftlicher; die Station dient als Entwicklungsumgebung, die identische Software-Stacks nutzt und nahtlos auf Cluster oder Cloud migriert werden kann.
Wie unterscheidet sich die DGX Station von klassischen Workstations und GPU-Servern?
- Kohärenter Speicher: CPU (Grace) und GPU (Blackwell) teilen sich einen einheitlichen Adressraum – Modelle müssen nicht mehr umständlich zwischen RAM und VRAM verschoben werden.
- Integration: Out-of-the-box abgestimmter Stack (Hardware, Kühlung, Software) statt Einzelkomponenten-Zusammenstellung.
- Bereitstellung: Bürotauglich, platzsparend – kein Serverraum-Umbau nötig.
Wie lässt sich die DGX Station vernetzen oder mit weiteren Systemen koppeln?
Die DGX Station verfügt über dedizierte NVIDIA-ConnectX-8-Konnektivität – gekoppelt mit einer zweiten DGX Station stehen bis zu 800 Gbps zur Verfügung. So lassen sich zwei Stationen für größere Modelle zusammenschließen; für Multi-Node-Setups im Rechenzentrum stehen zudem die bekannten DGX/HGX-Plattformen mit NVLink und InfiniBand zur Verfügung.
Welcher Software-Stack läuft auf der DGX Station? (CUDA-X, PyTorch, TensorFlow, JAX)
Die DGX Station nutzt den bewährten NVIDIA-Stack: CUDA bzw. CUDA-X als Foundation, darunter Frameworks wie PyTorch und TensorFlow (über CUDA), NVIDIA-TensorRT für Inferenz-Optimierung sowie Container-Tooling. Workloads lassen sich ohne Modifikationen auf DGX-Cluster oder in die Cloud verlagern – identische Umgebungen von Desktop bis Rechenzentrum.
Welche Kühlung, Stromversorgung und welcher Stellplatz sind erforderlich?
Die DGX Station ist als bürotaugliches, flüssigkeitsgekühltes Kompaktsystem konzipiert – mit integrierter Kühlung und geringer Geräuschentwicklung. Der Energiebedarf ist workloadabhängig (kein durchgehender Volllastbetrieb wie im Rackscale-Betrieb); ein normaler Arbeitsplatz mit stabiler Stromversorgung reicht aus. Für Mehrfach-Setups im Serverraum gelten die jeweiligen OEM-Vorgaben zu Luftstrom und Stromschienen.
Wie adressiere ich Datenschutz, Sicherheit und Compliance (DSGVO, ISO 27001, BSI)?
- Datenverarbeitung vollständig lokal (on-prem) – sensible Daten verbleiben im Haus, kein Cloud-Transfer nötig.
- Rollen- & Rechtekonzepte, verschlüsselte Datenspeicher, Audit-Logging und SIEM-Integration.
- Daten-Governance: Anonymisierung/Pseudonymisierung sowie Auftragsverarbeitung nach DSGVO.
Wie dimensioniere ich den Einsatz der DGX Station im Unternehmen? (Sizing & Benchmarks)
Prüfen Sie mit repräsentativen Workloads (Ihre Modelle, Kontextlängen, Batch-Größen), ob Modellgröße und Speicherbedarf in den 748-GB-Bereich passen. Für Teams mit mehreren Parallelanwendungen oder Serve-Anforderungen empfiehlt sich die Kopplung zweier Stationen (bis zu 800 Gbps ConnectX-8) oder ein DGX/HGX-Cluster als Folgeausbaustufe.
Kontaktieren Sie uns gern jederzeit.